RTX 3080 + Tesla T10,36G 显存塞下 763B:DeepSeek-V4.1-Flash 2-bit 双卡实测,鹈鹕骑单车对比官方
家用双卡 36G 跑 2.00bpw 的 DeepSeek-V4.1-Flash:魔塔拉 132GB、闲置 300 秒自动卸载、32K 撞顶升 64K、补 sm_75 重编双卡提速到 10.73 tok/s;Harness 自主 15 轮写 SVG 动画,和官方版并排对比,附两份 HTML 下载。
目录· 11 节
AI 工具实战 · 本地大模型 · 双卡实录
763B 参数的 MoE 模型,官方 API 用起来很香,但本地化的门槛看起来是「8 张 H100 起步」。我手里只有一张捡垃圾淘来的 Tesla T10(16G) 和一张 RTX 3080 20G,两张卡加起来 36G 显存,更糟的是 3080 因为主板槽位拆分,只能跑在 PCIe x4 上。
这次要跑的是压到 2.00bpw(每个权重只有 2 个比特)的 DeepSeek-V4.1-Flash。很多人的第一反应是:2-bit 早就「脑萎缩」了,能用吗?
我的做法是不争论,直接让它干活:在 DeepSeek-harness 里丢一句「用 SVG 制作一个鹈鹕骑单车的 html」,让它自己跑完,再和官方原生模型做的同一题并排放。
硬件:一张「垃圾佬」T10 + 一张跑在 x4 上的 3080
| 组件 | 配置与实际状态 | 在这次部署里干什么 |
|---|---|---|
| GPU 0(副卡) | Tesla T10 16GB(Turing / sm_75),PCIe Gen3 x8 | 承载第 0–19 层,提供 15.3GB 显存 |
| GPU 1(主卡) | RTX 3080 20GB(Ampere / sm_86),PCIe 协商降到 x4 | 承载第 20–39 层 + 输出头,提供 19.5GB 显存 |
| 双卡合计 | 35.8GB 聚合显存 | Dense 层常驻 + 约 3,000 个激活专家 |
| 主机内存 | 64GB DDR4(可用约 60GB) | 41.6GB RAM Store,常驻 3,790+ 个高频专家,免掉 NVMe 寻道 |
| 总线约束 | PCIe x4,带宽只有 2–6 GB/s | 专家在内存和显存之间换入时是最大瓶颈 |
| 共存要求 | 机器上常驻 8080(llama.cpp)和 8081(Notion AI)两个服务 | 推理模型必须用时拉起、闲置彻底卸载显存 |
最后一行是很多人忽略的:这不是一台专门跑 DeepSeek 的机器,它平时还要干别的活。所以下面的每一步,都绕着「别把别的服务挤死」来做。
四次部署攻坚
1. 下载:HuggingFace 老断,改走魔塔
763B 模型的 GGUF 有 6 个分卷、约 132GB。走 HuggingFace 国际源,带宽一抖就断连。
解决办法很朴素:写了一个拉取流水线,直接锁定国内魔塔社区(ModelScope)镜像 CDN,多线程稳态拉取 6 个分卷,加上 Engram 联想库和 DSpark 路由表,最后按 Strata 格式校验打包成 data/packs/dsv41_2.00bpw。
2. 显存不能常驻:写一个按需唤醒的代理
36G 显存如果被 DeepSeek 长期占满,8080 和 8081 两个现有服务会直接 OOM。
我写了一个独立守护代理 strata-proxy.py(端口 8090),下游是 systemd 服务 strata-backend.service(端口 8091):
- 首个请求冷启动:客户端打到 8090 时,代理现场拉起后端,完成双卡权重加载和 RAM 专家映射;
- 流式零缓冲:SSE 逐块直通,打字机手感不受影响;
- 闲置自动回收:300 秒(5 分钟) 没有请求就停掉服务,两张卡的显存回到 0 MiB / 1 MiB。
3. 任务「爆了」:32K 撞顶,升到 64K
之前跑长程多轮 Agent 任务,客户端提示「任务爆了,被迫中断」。查下来是这么一串:
- DeepSeek-harness 连续跑了 10 多轮脚本和代码,Prompt 累积到 32,169 Tokens;
- 服务配置的硬上限是 32,768(32K),留给生成的只剩
32768 - 32169 = 599Tokens; - 思考链先吃掉约 300 Tokens,代码写到一半撞顶截断(
done: 599 tokens (length)),吐出残破的 XML,Harness 解析器直接崩。
好消息是 DeepSeek-V4.1-Flash 用的是 MLA 注意力,KV Cache 很小——64K 上下文全层只占约 60MB 显存。于是全链路把 --max-context 翻倍到 65,536(64K),单次补全预算上限放宽到 32K。后面实测上下文冲到 4.7 万 Tokens,就是靠这一步。
4. 核心提速:T10 起不来、3080 慢如龟
最初只有 RTX 3080 单卡在跑,速度 4–5 tok/s,T10 根本起不来。
3080 为什么慢:lspci -vvv 一查,3080 协商在 PCIe x4。763B 模型有 122GB 专家放在内存里,单卡 20G 只能放下 1,155 个专家(不到 8%)。每解码一个 Token,GPU 都要通过窄窄的 x4 去内存拉专家,大部分时间在 Memory Stall 空转。
T10 为什么起不来:官方预编译的 strata-dsv41 只打包了 sm_86/89/120,没有 Turing 需要的 sm_75 算子,一调用 T10 就报 cudaErrorNoKernelImageForDevice。
解决:本地源码重编,打双架构
- 用本地 CUDA 12.6 工具链配 CMake,目标架构写
sm_75+sm_86; - Ninja 编完 63 个底层算子单元,把
libcudart、libcublas、libcublasLt这些 CUDA 12 动态库一起收进来,做成自包含包0.1.55-linux-x86_64-cuda-dual; - 打开双卡流水线切分
--gpus 0,1:T10 扛第 0–19 层,3080 扛第 20–39 层和 LM Head。
| 指标 | 单 3080 | 双卡 T10 + 3080 |
|---|---|---|
| 显存常驻专家 | 1,140 | 2,999(2.63 倍) |
| 走慢速通道的专家比例 | 74% | 4%–7.9% |
| 生成速度 | 4–5 tok/s | 7.5–10.73 tok/s |
加上内存 Cache,总共 6,795 个专家不用碰磁盘。一张被官方二进制「忽略」的 T10,补上 sm_75 之后直接让速度翻倍。
实战:Harness 自主跑 15 轮,写一只骑车的鹈鹕
在 DeepSeek-harness 里下发「用 SVG 制作一个鹈鹕骑单车的 html」,模型自己跑了 15 轮工具链,用时 1 小时 1 分 42 秒。引擎启动日志:
[strata] engine started: strata-dsv41 --serve --pack dsv41_2.00bpw --gpus 0,1 --max-context 65536
ds4: CUDA0 (Tesla T10)  layers [0, 19]: weights 2.81 GB, experts 11.10 GB (1325 in VRAM)
ds4: CUDA1 (RTX 3080)   layers [20, 39] + head: weights 3.05 GB, experts 15.21 GB (1674 in VRAM)
ds4: RAM store: 3796 of the profile's hottest experts read in (29.5 GB) in 18.7 s
关键轮次的真实监控数据
| 轮次与行为 | 上下文总 Token | 前缀缓存复用 | 新增计算 | 本轮生成 Token | 速度 (tok/s) | 走慢速总线专家 |
|---|---|---|---|---|---|---|
| Turn 1 规划与构思 | 9,016 | 8,457(93.8%) | 559 | 3,706 | 8.89 | 1.8% |
| Turn 2 骨架与脚本计算 | 12,795 | 12,721(99.4%) | 74 | 7,491 | 9.16 | 4.3% |
| Turn 3 核心 SVG 大段代码 | 29,121 | 29,106(99.9%) | 15 | 9,655 | 10.73 | 6.2% |
| Turn 4 坐标反思与包围盒校准 | 43,959 | 43,392(98.7%) | 567 | 903 | 7.70 | 7.6% |
| Turn 5 收尾与 HTML 交付 | 47,261 | 47,223(99.9%) | 38 | 120 | 5.98 | 7.9% |
几个值得记下来的点:
- 前缀缓存复用 98%–99.9%:4 万多 Token 的长会话,每轮新增 Prefill 只要 4–8 秒;
- 单次最大吞吐:在 29K 上下文时一口气吐出 9,655 Tokens,平均 10.73 tok/s;
- 92% 以上的激活专家直接在双卡显存和 RAM 里命中,PCIe x4 不再是死结;
- 它不只是写代码:会自己写 Python 脚本算 Bounding Box 防穿模,还会先画 ASCII 字符画预演构图。
顺带一提默认参数:thinking_mode = "thinking",reasoning_effort = "high"(映射为 75/100),服务端默认思考预算 DS41_DEFAULT_BUDGET = 32768;客户端 max_tokens 给得小(4K、8K)时,服务端会把思考预算压到 max_tokens 的 50%–75%,至少给正文留 512–1024 Tokens,避免「想太多、正文写不出来」。
对决:官方原生 vs 本地 2.00bpw
同一个需求,两边各自独立写出的页面:
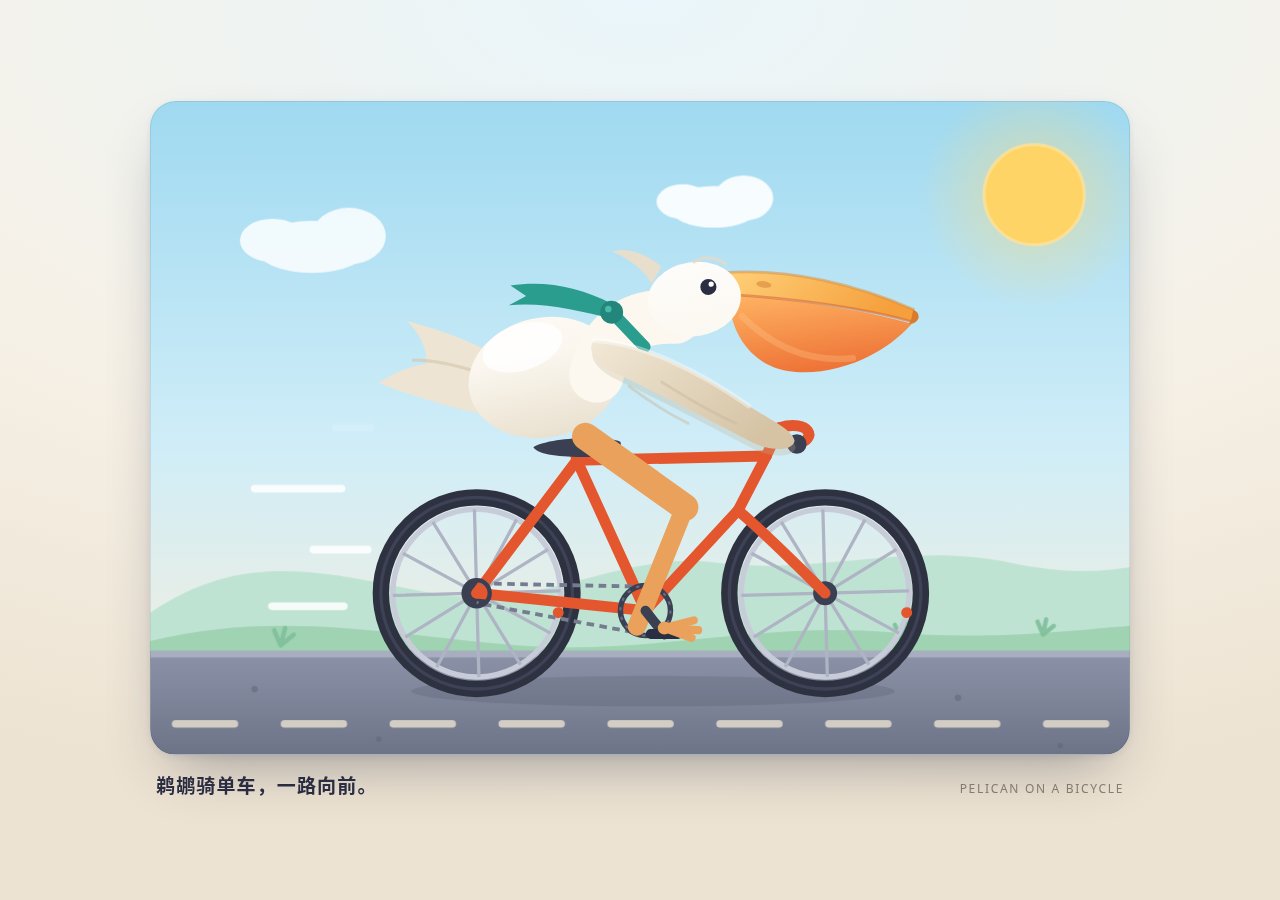
官方全精度 / FP8 原生模型:北欧复古平面风,珊瑚红车架(#E4572E)+ 绿围巾(#2A9D8F)撞色。
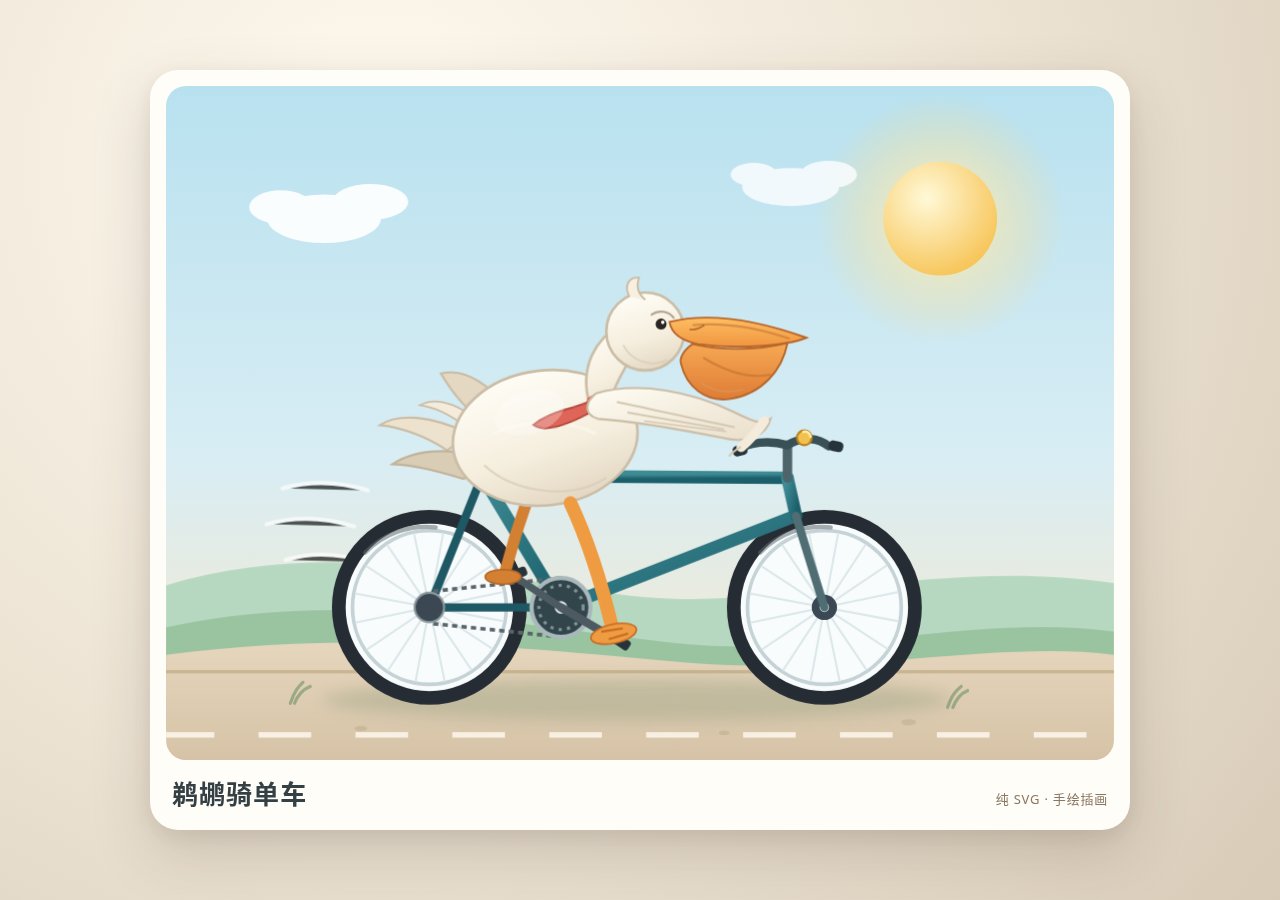
本地双卡 2.00bpw:暖调手绘绘本风,青绿渐变车架(#3e8b94–#1b5f6b)+ 暖阳金与奶油白,地面车影用 feGaussianBlur 柔化。
| 维度 | 官方原生(全精度 / FP8) | 本地 2.00bpw |
|---|---|---|
| 整体画风 | 北欧复古现代平面风 | 暖调治愈系手绘绘本风 |
| 动力学 | 12 帧反向运动学(IK 连杆计算),大腿、小腿角度跟着踏板联动 | 插画式复合微动效:全车微起伏、车轮自转、围巾摆动、路面后退 |
| 细节与光影 | 线条块面硬朗,喉囊带弹性微抖动 | 三层渐变尾羽、高斯模糊柔和车影 |
| 动画实现 | SVG SMIL 原生动效(<animateTransform>) | CSS3 @keyframes |
| 代码 | 370 行,标签 100% 闭合 | 372 行,标签 100% 闭合 |
截图是静态的,动画要打开 HTML 才看得到(纯本地文件,双击用浏览器打开即可):
- 下载 · 官方原生版 pelican-bike-official.html(约 18KB,看 IK 蹬车和喉囊微抖)
- 下载 · 本地 2.00bpw 版 pelican-bike-local-2bpw.html(约 18KB,看绘本风和柔和车影)
我的判断
官方赢在硬核推理。 它在深度思考下真的把蹬车的连杆反向运动学算出来了,腿的动作有物理感——这是全精度模型数学推理深度的体现,2-bit 版这次没做到。
2-bit 版赢在「没塌」。 每个权重只剩 2 个比特,它没有结构崩坏、没有审美降级:
- 严格照着要求来(青绿车架、奶油色羽毛、长喙朝前);
- 构图和配色有修养,渐变和高斯模糊的用法,插画质感我甚至更喜欢;
- 自主工具链能力完整:自己写脚本测包围盒、先画字符画预演。
我的主观结论:本地 36G 跑的 2.00bpw,保留了官方原生模型九成以上的「心智」和交付水准——至少在这道题上,「2-bit 干不了正经工程」的说法站不住。差距主要在需要深度数学推演的地方。
这套方案适合谁
- 适合:手里有闲置的老卡(比如这张 T10)和一张游戏卡、内存 64G 左右、想在本地跑大 MoE 模型做 Agent 长任务的人。慢一点(7.5–10.73 tok/s)能接受,但要上下文长、要隐私、要不按 Token 计费。
- 适合:机器上还有别的服务的人——按需唤醒 + 闲置 300 秒卸载这一套,比模型本身更值得抄。
- 不适合:要求实时对话手感、或者任务重度依赖精密数学推演的场景,官方 API 仍然更稳。
- 最值钱的三条经验:
- 先
lspci -vvv看清每张卡的 PCIe 通道,速度瓶颈常常不在卡本身; - 官方二进制不认你的老卡,先查它打包了哪些
sm_xx,自己补编; - Agent 长任务「爆了」,先算一下上下文硬上限还剩多少生成配额。
- 先
2.00bpw 曾经被当成不可用的极限玩具。这次在家用双卡上,它能保持审美直觉、工程逻辑和完整的 Agent 工具调用。配合合理的双卡切分和按需卸载,个人家用服务器也能把 700B 级别的模型跑起来干活。
前几期都在折腾图和视频,比如开源 Toonflow 保姆级实测 1 分钟漫剧;这期换成本地大模型,后面会继续记录这台双卡机器能接的活。
同一栏目
工具实测全部 →不会写分镜也能拍:开源 Toonflow 保姆级实测,1 分钟漫剧从剧本到成片
Docker 装 Toonflow、稍后配置进画布、雨夜便利店扩到 60 秒 14 镜;附分镜模板、定妆图、失败账单、协议红绿灯。
同一个剧本,三家 AI 拍 15 秒漫剧:Muse vs Grok vs 本地 H3
同剧本同关键帧,Muse、Grok Imagine Video 1.5、本地 MiniMax H3 各拼一条 15 秒漫剧;记下耗时、分辨率、拼镜 vs 单段、显存坑与接缝。